"Kendi yapay zeka modelimizi eğitmek istiyoruz" cümlesi son iki yılda birçok şirketin gündemine girdi. Arkasında çoğu zaman makul bir ihtiyaç var: Şirket verisi dışarı çıkmasın, model sektörün dilini konuşsun, aylık API faturası kontrol altında kalsın. Ama "eğitmek" kelimesi, birbirinden çok farklı maliyet ve risk taşıyan dört ayrı işi aynı başlık altında topluyor. Yanlış olanı seçen bir proje, aylarca GPU kiralayıp sonunda iyi yazılmış bir prompt'un yapabileceği işi yapan bir modelle bitebiliyor.
Bu yazıda açık kaynak (daha doğru ifadeyle açık ağırlıklı) bir dil modelini kendi verinizle uyarlamanın nasıl yapıldığını, karar noktalarıyla anlatıyoruz. Teknik iddiaların her birini ilgili makaleye, resmi dokümantasyona ya da lisans metnine bağladık.
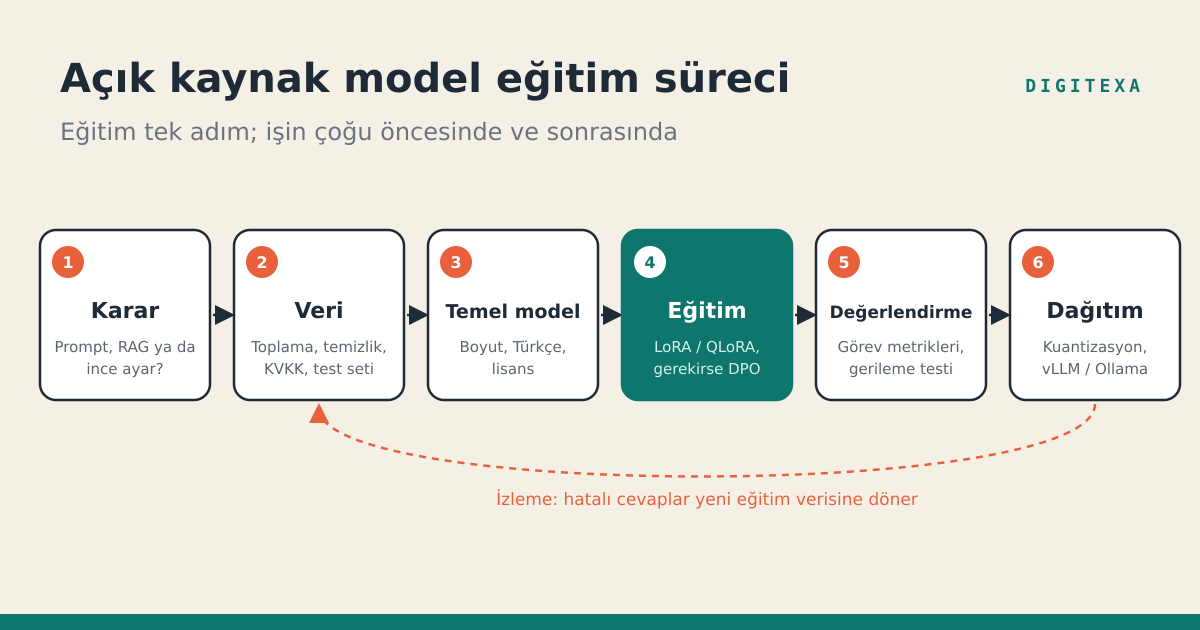
Kısa cevap: Açık kaynak bir yapay zeka modelini eğitmek çoğu şirket için sıfırdan model eğitmek değil, hazır bir modeli kendi verisiyle ince ayar (fine-tuning) yapmaktır. Bilgi güncel kalmalıysa önce RAG denenir; üslup, format ya da dar bir görev öğretilecekse LoRA veya QLoRA ile ince ayar yapılır. QLoRA sayesinde 65 milyar parametrelik bir model tek bir 48 GB GPU'da eğitilebiliyor. Başarıyı belirleyen GPU değil; temiz ve dengeli veri, eğitime hiç girmeyen bir test seti, doğru lisans seçimi ve KVKK'ya uygun veri hazırlığıdır.
Önce Şu Soru: Gerçekten Eğitmeniz Gerekiyor mu?
Bir model eğitimi projesine "Model neyi bilmiyor, neyi yapamıyor?" sorusuyla başlarız. Bu iki eksik farklı araçlarla çözülür.
Bilgi eksikliği (ürün kataloğu, iç yönetmelik, güncel fiyat listesi) genellikle eğitimle değil, RAG ile çözülür. RAG, modelin ağırlıklarındaki bilgiyi dışarıdan aranan bir bellekle birleştirir; yöntemi tanıtan makale bunu, modelin bilgisini güncelleme ve cevabın kaynağını gösterme sorunlarına çözüm olarak konumlar (Lewis ve ark., 2020). Fiyat listesi değiştiğinde modeli yeniden eğitmezsiniz; belgeyi güncellersiniz.
Davranış eksikliği (belirli bir formatta yanıt vermek, kurum üslubunu tutturmak, dar bir sınıflandırma görevini tutarlı yapmak) ise ince ayarın asıl alanıdır.
| Yaklaşım | Ne zaman uyar? | Gereken veri | Maliyeti belirleyen |
|---|---|---|---|
| Prompt mühendisliği | Görev birkaç örnekle anlatılabiliyorsa, hacim düşükse | Birkaç iyi örnek ve net talimat | Her çağrıdaki token sayısı |
| RAG | Bilgi sık değişiyorsa, cevabın kaynağı gösterilmeliyse | Düzenli, aranabilir belgeler | Belge hazırlığı, arama altyapısı, bağlam uzunluğu |
| İnce ayar (LoRA / QLoRA) | Üslup, format ya da dar bir görev tutarlı yapılmalıysa | Yüzlerce ila birkaç bin kaliteli örnek | Veri hazırlama emeği, GPU süresi, değerlendirme |
| Sürdürülmüş ön eğitim (continued pre-training) | Model alanın dilini hiç tanımıyorsa (çok özel terminoloji, düşük kaynaklı dil) | Etiketsiz, büyük hacimli alan metni | Çok daha uzun GPU süresi, veri temizliği |
| Sıfırdan eğitim | Neredeyse hiçbir şirket için değil | Trilyonlarca token mertebesinde metin | Büyük GPU kümeleri; örneğin Qwen3 yaklaşık 36 trilyon token ile eğitildi (Qwen) |
Pratikte en sağlıklı sonuç çoğu zaman bir karışımdan çıkar: Bilgiyi RAG verir, ince ayar modele o bilgiyi doğru formatta ve doğru üslupla kullanmayı öğretir.
Temel Modeli Seçmek: Boyut, Türkçe, Lisans ve Bağlam
Temel model seçimi projenin geri kalanını belirler. Dört kritere bakarız.
Boyut ve donanım
Parametre sayısı arttıkça kalite genellikle artar, ama eğitim ve çalıştırma maliyeti de büyür. Önce modelin nerede çalışacağını sorarız. Örneğin Mistral'in model kartı, 24 milyar parametrelik Mistral Small 3.1'in bf16 hassasiyette yaklaşık 55 GB GPU belleği istediğini, nicemlendiğinde (quantization) ise tek bir RTX 4090'a sığdığını belirtiyor (Mistral Small 3.1 model kartı).
Türkçe yeteneği
"Çok dilli" etiketi, Türkçede iyi olduğu anlamına gelmez. Model kartlarında Türkçenin açıkça listelenip listelenmediğine bakarız: Mistral Small 3.1'in kartında Türkçe destek verilen diller arasında sayılıyor, Qwen3 ise 119 dil ve lehçeyi desteklediğini ve Türkçeyi Türk dilleri grubunda listelediğini açıklıyor (Qwen3 duyurusu).
Bir de görünmeyen maliyet var: tokenizer. Aynı metnin farklı dillerde 15 kata varan farklı token uzunluklarına bölünebildiği gösterildi; bu fark maliyeti, gecikmeyi ve bağlam penceresine sığan metin miktarını doğrudan etkiliyor (Petrov ve ark., 2023). Eklemeli bir dil olan Türkçede, aday modellerin tokenizer'ını kendi örnek metinlerimizle ölçmeden karar vermeyiz.
Lisans: "Açık" her zaman aynı anlama gelmiyor
Açık ağırlıklı modellerin lisansları birbirinden çok farklı. Ticari bir ürün için en sık karşılaştığımız aileler:
| Model ailesi | Lisans | Dikkat edilecek nokta |
|---|---|---|
| Qwen3 (açık ağırlıklı modeller) | Apache 2.0 (Qwen) | Standart izin verici lisans; her modelin kendi kartı yine de kontrol edilmeli |
| Mistral Small 3.1 | Apache 2.0 (model kartı) | Ticari ve ticari olmayan kullanım ile değişikliğe izin veriyor |
| Gemma 4 | Apache 2.0 (model kartı) | Önceki Gemma sürümleri farklı bir lisansta |
| Önceki Gemma sürümleri | Gemma Terms of Use (Google) | Yasaklı Kullanım Politikası sözleşmeye dahil; türev modeli dağıtırken kısıtları alıcıya aktarma ve bildirim yükümlülüğü var |
| Llama 3.3 | Llama 3.3 Community License (lisans metni) | Aylık 700 milyonun üzerinde aktif kullanıcıda Meta'dan ayrı lisans gerekir; "Built with Llama" ibaresi gösterilmeli; dağıtılan türev modelin adı "Llama" ile başlamalı; Kabul Edilebilir Kullanım Politikası sözleşmenin parçası |
Lisans kontrolünü teknik seçimden önce yaparız: Eğitilmiş modeli bir ürüne gömecekseniz, dağıtım koşulları ürün tasarımını doğrudan etkiler.
Bağlam uzunluğu
Uzun sözleşmeler ya da çok adımlı yazışmalar işlenecekse bağlam penceresi belirleyicidir. Qwen3'ün büyük yoğun modelleri 128K token destekliyor (Qwen), Mistral Small 3.1 128K (model kartı), Gemma 4'ün orta ve büyük modelleri 256K (model kartı). Eğitimde kullanılan dizi uzunluğu da bellek ihtiyacını büyütür.
Veri: Projenin Gerçek İşi
Bir ince ayar projesinde zamanın büyük kısmı GPU başında değil, veri başında geçer.
Miktardan önce kalite
İki bulgu bu konuda yol gösterici. LIMA çalışmasında 65 milyar parametrelik bir model yalnızca 1.000 özenle seçilmiş örnekle ince ayar yapıldı ve insan değerlendirmelerinin yüzde 43'ünde GPT-4'e denk ya da tercih edilen yanıtlar üretti (Zhou ve ark., 2023). QLoRA makalesinde ise sohbet performansında 9 bin örnekli OASST1 veri setinin, alt örneklenmiş 450 bin örnekli FLAN v2'yi geride bıraktığı raporlandı (Dettmers ve ark., 2023). Yani 50 bin gürültülü örnek, 2 bin temiz örnekten daha iyi değildir.
Toplama ve temizleme
Kaynak genellikle destek talepleri, e-posta yazışmaları, teklif metinleri ya da iç dokümanlardır. Temizlikte şunlara bakarız: tekrar eden kayıtlar, yanlış ya da eskimiş cevaplar, şablon imzalar ve otomatik metinler, bir sınıfın veri setini ezip geçtiği dengesizlikler. Model, gösterdiğiniz her şeyi öğrenir; kötü cevapları da.
Kişisel veri ve KVKK
Gerçek yazışmalardan gelen veri neredeyse her zaman ad, telefon, adres, T.C. kimlik numarası gibi kişisel veriler içerir. 6698 sayılı KVKK'nın 4. maddesi verinin işlendikleri amaçla bağlantılı, sınırlı ve ölçülü işlenmesini ve gerekli süre kadar saklanmasını ister; 7. maddesi ise amaç ortadan kalktığında verinin silinmesini, yok edilmesini ya da anonim hale getirilmesini düzenler. Modelin bir müşterinin telefon numarasını öğrenmesine ihtiyaç yoktur. Bu yüzden kişisel verileri eğitimden önce tespit edip maskeleriz ya da çıkarırız; maskelenmiş veriyi de ayrıca örneklem alarak kontrol ederiz.
Eğitim ya da çıkarım yurt dışındaki bir bulut sunucusunda yapılacaksa ayrı bir başlık açılır: KVKK'nın yurt dışına aktarımı düzenleyen 9. maddesi 7499 sayılı Kanunla değiştirildi ve Kurul, standart sözleşme metinlerini 2024/959 sayılı kararıyla kabul etti (KVKK duyurusu). Burada hukuk danışmanınızın görüşü şarttır; açık ağırlıklı modellerin avantajı, gerektiğinde tamamen şirket içinde çalıştırılabilmeleridir.
Format ve sohbet şablonu
Veri, eğitim aracının beklediği biçime dönüştürülür. Hugging Face TRL kütüphanesi düz metin, istem-tamamlama (prompt-completion) ve messages alanlı sohbet formatlarını destekliyor; sohbet formatında modelin sohbet şablonunu otomatik uyguluyor (TRL SFT dokümantasyonu). İstem-tamamlama verisinde kayıp (loss) varsayılan olarak yalnızca tamamlama kısmında hesaplanıyor; sohbet verisinde yalnızca asistan cevaplarından öğrenmek için assistant_only_loss ayarı gerekiyor.
Sentetik veri
Büyük bir modelle örnek üretmek veri açığını hızla kapatır, ama bedeli var. Modellerin kendi ürettikleri içerikle tekrar tekrar eğitildiğinde orijinal dağılımın "kuyruklarının" kaybolduğu, yani nadir ama önemli durumların silindiği gösterildi (Shumailov ve ark., 2023). Sentetik veriyi gerçek verinin yerine değil, onu tamamlamak için ve insan kontrolünden geçirerek kullanırız.
Test setini en başta ayırmak
Eğitim başlamadan önce verinin bir kısmını kilitleriz ve bir daha dokunmayız. Bu set, hem eğitim hem hiperparametre seçiminde kullanılmamalıdır. Aynı müşterinin ya da aynı belgenin parçalarının hem eğitim hem test setinde bulunması, sonuçları olduğundan iyi gösteren en yaygın veri sızıntısı biçimidir; ayrımı kayıt bazında değil, kaynak bazında yaparız.
Yöntem: Tam İnce Ayar, LoRA ve QLoRA
Bellek neden bu kadar büyük?
Hugging Face'in bellek dökümüne göre karma hassasiyetli eğitimde model ağırlıkları parametre başına 6 bayt, Adam optimizer durumları 8 bayt, gradyanlar 4 bayt yer kaplar; buna batch boyutu ve dizi uzunluğuyla büyüyen aktivasyonlar eklenir (Transformers, GPU bellek kullanımı). Toplam parametre başına yaklaşık 18 bayttır. Basit bir hesapla 7 milyar parametrelik bir modelin tam ince ayarı, aktivasyonlar hariç 7 × 18 = 126 GB bellek ister. Bu, tek bir GPU'nun sınırının çok üzerindedir.
LoRA: Modeli değil, küçük bir eki eğitmek
LoRA, orijinal ağırlıkları dondurur ve her katmana düşük ranklı, eğitilebilir iki küçük matris ekler. Yöntemi tanıtan makaleye göre GPT-3 175B üzerinde Adam ile tam ince ayara kıyasla eğitilebilir parametre sayısı 10.000 kat, GPU bellek ihtiyacı 3 kat azalıyor; kalite tam ince ayarla aynı seviyede ya da daha iyi kalıyor ve ek çıkarım gecikmesi oluşmuyor (Hu ve ark., 2021). Optimizer durumu ve gradyan yalnızca bu küçük matrisler için tutulur.
Pratikte iki ayar önemlidir: rank (r) ve LoRA'nın uygulanacağı katmanlar. PEFT dokümantasyonu, QLoRA makalesindeki yaklaşımı izleyerek LoRA'yı yalnızca dikkat katmanlarına değil all-linear ile tüm doğrusal katmanlara uygulamanın tam ince ayara yakın performans verdiğini aktarıyor (PEFT, LoRA). Eğitim sonunda adaptör ana modelle birleştirilebilir ya da ayrı dosya olarak tutulabilir.
LoRA'nın sınırını da bilmek gerekir: Bir çalışma, kod ve matematik gibi alanlarda standart LoRA ayarlarının tam ince ayarın gerisinde kaldığını, buna karşılık modelin hedef alan dışındaki yeteneklerini daha iyi koruduğunu gösterdi (Biderman ve ark., 2024).
QLoRA: Donmuş modeli 4 bite sıkıştırmak
QLoRA, donmuş temel modeli 4 bit NormalFloat (NF4) formatında tutar, nicemleme sabitlerini de ikinci kez nicemler (double quantization) ve bellek sıçramalarını "paged optimizer" ile yönetir. Sonuç, makalenin ifadesiyle 16-bit ince ayar performansını koruyarak 65 milyar parametrelik bir modeli tek bir 48 GB GPU'da eğitebilmektir (Dettmers ve ark., 2023).
Kaynak: Dettmers ve ark., QLoRA: Efficient Finetuning of Quantized LLMs (2023)
Unsloth'un asgari VRAM tablosu, aynı model boyutunda 16-bit LoRA ile 4-bit QLoRA arasındaki farkı gösteriyor:
Unsloth bu değerlerin "mutlak asgari" olduğunu not ediyor; kapasite planını bu tablonun üzerine pay bırakarak yaparız.
Tercih eğitimi: DPO
İnce ayar modele "nasıl cevap verileceğini" gösterir; ama iki makul cevaptan hangisinin daha iyi olduğunu öğretmek için tercih verisi gerekir. Klasik RLHF önce bir ödül modeli eğitip sonra pekiştirmeli öğrenme uygular. DPO ise aynı hedefi basit bir sınıflandırma kaybıyla çözer; makaleye göre kararlı, hesaplama açısından hafiftir ve eğitim sırasında modelden örnek üretmeyi gerektirmez (Rafailov ve ark., 2023). Kullanıcılarınızın "bu cevap daha iyiydi" geri bildirimlerini topluyorsanız, ince ayardan sonraki doğal adım budur.
Araçlar
- Transformers + PEFT + TRL: Hugging Face ekosisteminin temeli. TRL;
SFTTrainer,DPOTrainer,GRPOTrainergibi eğiticileri sunuyor ve PEFT ile entegre çalışıyor (TRL). - Unsloth: TRL dokümantasyonuna göre eğitimi 2 kata kadar hızlandırıp VRAM kullanımını yüzde 70'e kadar azaltıyor (TRL SFT). Tek GPU'lu projelerde ilk tercihimizdir.
- Axolotl: Veri ön işleme, eğitim, değerlendirme ve nicemlemeyi tek bir YAML dosyasıyla yöneten bir araç; tam ince ayar, LoRA, QLoRA, DPO ve FSDP2/DeepSpeed ile çok GPU'lu eğitimi destekliyor (Axolotl).
Donanım ve Maliyet: Neyi Hesaplamak Gerekir?
GPU fiyatları sağlayıcıya ve haftaya göre değiştiği için burada rakam vermiyoruz; bunun yerine maliyeti belirleyen kalemleri sıralıyoruz:
- Bellek ihtiyacı: Yukarıdaki tablo hangi GPU sınıfına ihtiyaç olduğunu belirler. 8B bir modeli QLoRA ile eğitmek ile 70B bir modeli 16-bit LoRA ile eğitmek arasında donanım sınıfı farkı vardır.
- Toplam token sayısı: Örnek sayısı × ortalama uzunluk × epoch. Eğitim süresini bu belirler.
- Deney sayısı: İlk eğitim neredeyse hiçbir zaman son eğitim değildir. Bütçeyi tek bir koşu için değil, birkaç deney için planlarız.
- Çalıştırma maliyeti: Eğitim bir kez yapılır, çıkarım her gün. Uzun vadede asıl kalem genellikle budur.
Bulut mu, şirket içi mi? Eğitim kısa süreli, dalgalı bir yük olduğu için çoğu zaman saatlik kiralanan bulut GPU'larında daha ekonomiktir. Çıkarım ise sürekli bir yüktür; veri zaten şirket içinde kalmak zorundaysa kendi donanımınız hızla anlamlı hale gelir. Kişisel veri içeren eğitim verisi için yukarıdaki KVKK başlığı burada da geçerlidir.
Değerlendirme: Model Gerçekten İyileşti mi?
"Eğitim kaybı düştü" bir başarı ölçütü değildir. Değerlendirmeyi üç katmanda yaparız.
1. Görev metrikleri: Kilitlediğimiz test seti üzerinde göreve uygun ölçüm: sınıflandırmada doğruluk ve sınıf bazlı hata, yapılandırılmış çıktıda geçerli JSON oranı ve alan doğruluğu, bilgi sorularında kaynağa sadakat. Ölçümü temel modelle ve iyi yazılmış bir prompt'la da yaparız; ince ayarın bu iki referansı geçmesi gerekir. Benchmark'ların neyi ölçüp neyi ölçmediğini benchmark nedir yazımızda ayrıntılı anlattık.
2. Genel yetenekte gerileme: Model yeni görevi öğrenirken eskiden yapabildiklerini unutabilir (catastrophic forgetting). Bu yüzden eğitim öncesi ve sonrası, alan dışı bir soru setiyle de ölçüm alırız. Türkçe genel bilgi için TurkishMMLU gibi, çeviri değil doğrudan Türkçe yazılmış setler değerlidir: Bu set, Türk lise müfredatındaki 9 dersten 10 binden fazla soruyu alan uzmanlarına yazdırarak oluşturuldu.
3. Yapay zeka hakemi (LLM-as-a-judge): Açık uçlu cevapları güçlü bir modele puanlatmak ölçeklenebilir bir yöntem; güçlü hakemlerin insan tercihleriyle yüzde 80'in üzerinde uyuştuğu raporlandı. Ama aynı çalışma hakemlerin cevabın sırasından, uzunluğundan ve kendi ürettiği metne benzerlikten etkilendiğini de gösterdi (Zheng ve ark., 2023). QLoRA makalesi de örnek düzeyinde GPT-4 ile insan değerlendiriciler arasında yalnızca orta düzeyde uyum ve öne konulan cevabı kayıran bir sıralama etkisi bildirdi (Dettmers ve ark., 2023). Bu yüzden cevapların sırasını karıştırırız, uzunluğu ayrıca raporlarız ve hakem puanlarının bir kısmını mutlaka insanla kontrol ederiz.
Türkçeye özgü tuzaklar: Makineyle çevrilmiş İngilizce test setleri çeviri hatalarını ölçüme taşır. Kelime örtüşmesine dayalı metrikler, eklemeli yapı yüzünden doğru ama farklı çekimlenmiş cevapları cezalandırabilir. Hakem talimatını da Türkçe yazar, ölçütleri örneklerle tarif ederiz.
Güvenlik ve kırmızı takım: Model yayına çıkmadan önce kasıtlı olarak zorlanır: sistem talimatını açıklatmaya çalışmak, eğitim verisindeki kişisel bilgiyi sızdırtmaya çalışmak, kapsam dışı konularda cevap ürettirmek. Kişisel veri maskelemesinin işe yarayıp yaramadığını görmenin en dürüst yolu budur.
Dağıtım: Eğitilmiş Modeli Yayına Almak
Nicemleme: Çıkarımda bellek ve hız için model genellikle düşük bit sayısına indirilir. AWQ, ağırlıkların yalnızca yüzde 1'lik önemli kısmını korumanın nicemleme hatasını ciddi biçimde azalttığı gözlemine dayanan, yalnızca ağırlıkları nicemleyen bir yöntemdir (Lin ve ark., 2023). GGUF ise llama.cpp'nin model formatıdır; 1,5 bitten 8 bite kadar tamsayı nicemleme seçenekleri sunar (llama.cpp). Nicemlenmiş modeli, değerlendirme setinden tekrar geçirmeden yayına almayız; kalite kaybı her görevde aynı değildir.
Sunucu yazılımı:
- vLLM: Yüksek trafikli GPU sunucuları için; OpenAI uyumlu Completions ve Chat Completions uç noktaları sunar (vLLM sunucu). Tek bir temel model üzerinde birden fazla LoRA adaptörünü istek bazında sunabiliyor (vLLM LoRA); AWQ, GPTQ, bitsandbytes ve GGUF dahil pek çok nicemleme yöntemini destekliyor (vLLM nicemleme).
- llama.cpp: Bağımlılıksız C/C++ uygulaması; CPU, Apple Silicon ve NVIDIA/AMD GPU'larda çalışır ve OpenAI uyumlu bir API sunucusu içerir (llama.cpp).
- Ollama: Safetensors ya da GGUF formatındaki modelleri içe aktarıp tek komutla çalıştırmayı sağlar. GGUF modelleri içe aktarırken nicemlemediği için modeli önceden llama.cpp araçlarıyla nicemlemek gerekir (Ollama, model içe aktarma).
Şirket içi kurulum: Veri hiçbir zaman dış bir API'ye gitmez; bedeli, sunucunun güncellenmesi, izlenmesi ve yedeklenmesi sorumluluğunun sizde olmasıdır.
İzleme ve yeniden eğitim: Yayından sonra cevap süresini, hata oranını ve kullanıcı geri bildirimini izleriz; düşük puanlı cevapları bir sonraki eğitim turunun aday verisi olarak ayırırız. Yeniden eğitimi takvime değil sinyale bağlarız: iş kuralı değiştiğinde, yeni bir ürün grubu eklendiğinde ya da izlenen metriklerde anlamlı bir düşüş görüldüğünde.
En Sık Görülen Hatalar
- Aşırı öğrenme (overfitting): Eğitim kaybı düşmeye devam ederken test seti sonuçlarının kötüleşmesi. Küçük veri setinde çok epoch ve yüksek öğrenme hızı tipik sebeptir. Doğrulama kaybını izler, en iyi kontrol noktasında dururuz.
- Unutma (catastrophic forgetting): Model yeni görevde iyileşirken genel yeteneklerini kaybeder. LoRA'yı tercih etmek ve alan dışı bir kontrol seti tutmak en pratik önlemdir.
- Sohbet şablonu uyumsuzluğu: Hugging Face dokümantasyonu, yanlış kontrol token'larıyla modellerin "çok daha kötü" performans göstereceğini açıkça belirtiyor (Transformers, sohbet şablonları). Eğitimde bir şablon, yayında başka bir şablon kullanmak; bitiş (EOS) token'ını hizalamamak ya da özel token'ları iki kez eklemek, modelin cevabı bitirememesi gibi tuhaf belirtilerle ortaya çıkar.
- Veri sızıntısı: Test örneklerinin bir kopyasının ya da aynı belgenin başka bir parçasının eğitime girmesi. Sonuçlar raporda harika, canlıda vasat olur.
- Yanlış problemi eğitmek: Bilgi eksikliğini ince ayarla çözmeye çalışmak; her bilgi değişikliği yeni bir eğitim demektir.
Bu İşi Kime Yaptırmalı? Doğru Ekibi Seçmek İçin Sorular
Teklif alırken teknoloji listesinden çok sürece bakın. Herhangi bir sağlayıcıya şunları sorun:
- Önce eğitim gerekmediğini kanıtlamaya çalışıyor musunuz? İyi bir ekip, prompt ve RAG ile alınacak sonucu referans olarak ölçer.
- Test setini ne zaman ve nasıl ayırıyorsunuz? Cevap "eğitimden önce, kaynak bazında" olmalı.
- Hangi temel modeli neden seçtiniz ve lisansı ürünümüzü nasıl etkiliyor? Lisans adını ve koşullarını söyleyebilmeliler.
- Kişisel veriyi nasıl tespit edip maskeliyorsunuz, eğitim nerede çalışıyor? KVKK'yı ve yurt dışına aktarımı kendiliğinden gündeme getirmeleri iyi bir işarettir.
- Başarıyı hangi metrikle ölçeceğiz ve genel yetenekteki gerilemeyi nasıl kontrol edeceksiniz? "Model daha iyi oldu" bir ölçüt değildir.
- Teslimde ne alıyoruz? Ağırlıklar ya da adaptör dosyası, eğitim yapılandırması, veri hazırlama kodu ve değerlendirme raporu sizde kalmalı. Model başka bir ekip tarafından yeniden eğitilebilmeli.
- Yayından sonra izleme ve yeniden eğitim nasıl işleyecek?
Genel olarak bir yazılım firmasını değerlendirirken bakılacak noktaları yazılım şirketi seçerken 10 kriter yazımızda topladık.
Sık Sorulan Sorular
Açık kaynak bir yapay zeka modelini kendi verimle eğitmek her zaman gerekli mi?
Hayır. Modelin şirketinize ait güncel bilgiyi bilmesi gerekiyorsa çoğu durumda önce RAG (belgelerden arama yapıp cevaba ekleme) denenmelidir. Fine-tuning; modelin belirli bir üslubu, formatı ya da dar bir görevi tutarlı biçimde yapması gerektiğinde ve bunu gösteren yüzlerce kaliteli örneğiniz olduğunda anlam kazanır.
LoRA nedir?
LoRA (Low-Rank Adaptation), modelin orijinal ağırlıklarını dondurup her katmana küçük, eğitilebilir matrisler ekleyen bir ince ayar yöntemidir. Yöntemi tanıtan makaleye göre GPT-3 175B üzerinde tam ince ayara kıyasla eğitilebilir parametre sayısını 10.000 kat, GPU bellek ihtiyacını 3 kat azaltır.
Bir dil modelini eğitmek için ne kadar GPU belleği gerekir?
Yönteme göre çok değişir. Hugging Face'in hesabına göre karma hassasiyette Adam ile tam ince ayar, aktivasyonlar hariç parametre başına yaklaşık 18 bayt ister; 7 milyar parametrelik bir model için bu 126 GB'ın üzerindedir. Unsloth dokümantasyonu ise 8B bir model için asgari ihtiyacı LoRA (16-bit) ile 22 GB, QLoRA (4-bit) ile 6 GB olarak veriyor.
Eğitim verisinde kişisel veri varsa KVKK açısından ne yapmak gerekir?
KVKK'nın 4. maddesi verinin amaçla bağlantılı, sınırlı ve ölçülü işlenmesini ister. Eğitim için kişisel veriye gerçekten ihtiyaç yoksa veri eğitimden önce anonimleştirilmeli ya da çıkarılmalıdır. Eğitim veya çıkarım yurt dışındaki bir sunucuda yapılacaksa, 2024'te değişen 9. madde kapsamındaki aktarım kuralları ayrıca değerlendirilmelidir.
Eğitilen model nasıl yayına alınır?
Genellikle model ya da LoRA adaptörü, vLLM gibi bir sunucu yazılımıyla OpenAI uyumlu bir API olarak sunulur. Daha küçük donanımlar için model GGUF formatına çevrilip llama.cpp veya Ollama ile çalıştırılabilir. Veri gizliliği önemliyse tüm bu yapı şirketin kendi sunucularında kurulabilir.
Son Söz
Açık kaynak bir modeli eğitmek artık büyük laboratuvarlara özgü değil; LoRA ve QLoRA tek bir GPU'yu bile yeterli hale getirdi. Zor olan teknik kurulum değil, karar zinciri: eğitmeli mi, hangi model, hangi lisans, hangi veri, hangi ölçüt. Yapay zeka projelerinin çoğu hazır bir API'ye bağlanmakla sınırlı kalır; veriyi hazırlamaktan değerlendirmeye ve kurum içi dağıtıma kadar bu zinciri uçtan uca yürütmek ayrı bir uzmanlık ister ve bunu yapan ekip sayısı azdır.
Elinizde bir kullanım senaryosu ve veri varsa, ilk adım olarak hangi yaklaşımın (prompt, RAG ya da ince ayar) size uyduğunu birlikte netleştirebiliriz. Modeli mevcut sistemlerinize bağlayacak bir yazılım katmanı gerekiyorsa özel yazılım geliştirme sürecimize göz atabilir, ihtiyacınızı teklif formu üzerinden paylaşabilirsiniz. Eğitim gerekmiyorsa bunu da açıkça söyleriz.